

在人工智能军备竞赛进行了整整两年后,一个被大多数从业者忽视的反常现象正在发生。
当市场将注意力全部押注在 GPU 的算力迭代上时,全球芯片巨头英特尔管理层却公开承认,其处理器产能仅能满足市场约一半的需求,交货周期拉长至半载。
更为反直觉的是,过去一台 AI 服务器由 1 颗 CPU 调度 8 颗 GPU,而在最新的推理与自主智能体(Agent)工作流中,这种配比正快速收紧至 1 比 4 甚至 1 比 1。
原本在 AI 浪潮中被视为“打下手”的 CPU,突如其来地成为了整套算力架构中的新瓶颈。这不仅是一场短期的供需失衡,更是算力负载从“GPU 单边消耗”向“CPU 与 GPU 异构协同”转变的底层信号。
如何厘清运算芯片的产业图谱?算力重构的背后隐藏着哪些未被完全定价的产业机会?本文将从半导体底层逻辑出发,拆解 CPU 与 GPU 的产业链全景,并推演行业重塑过程中的关键主线。
01.
行业定义重构算力的底层逻辑
从底层架构来看,算力芯片的核心功能是完成电子信号到逻辑运算的转换。
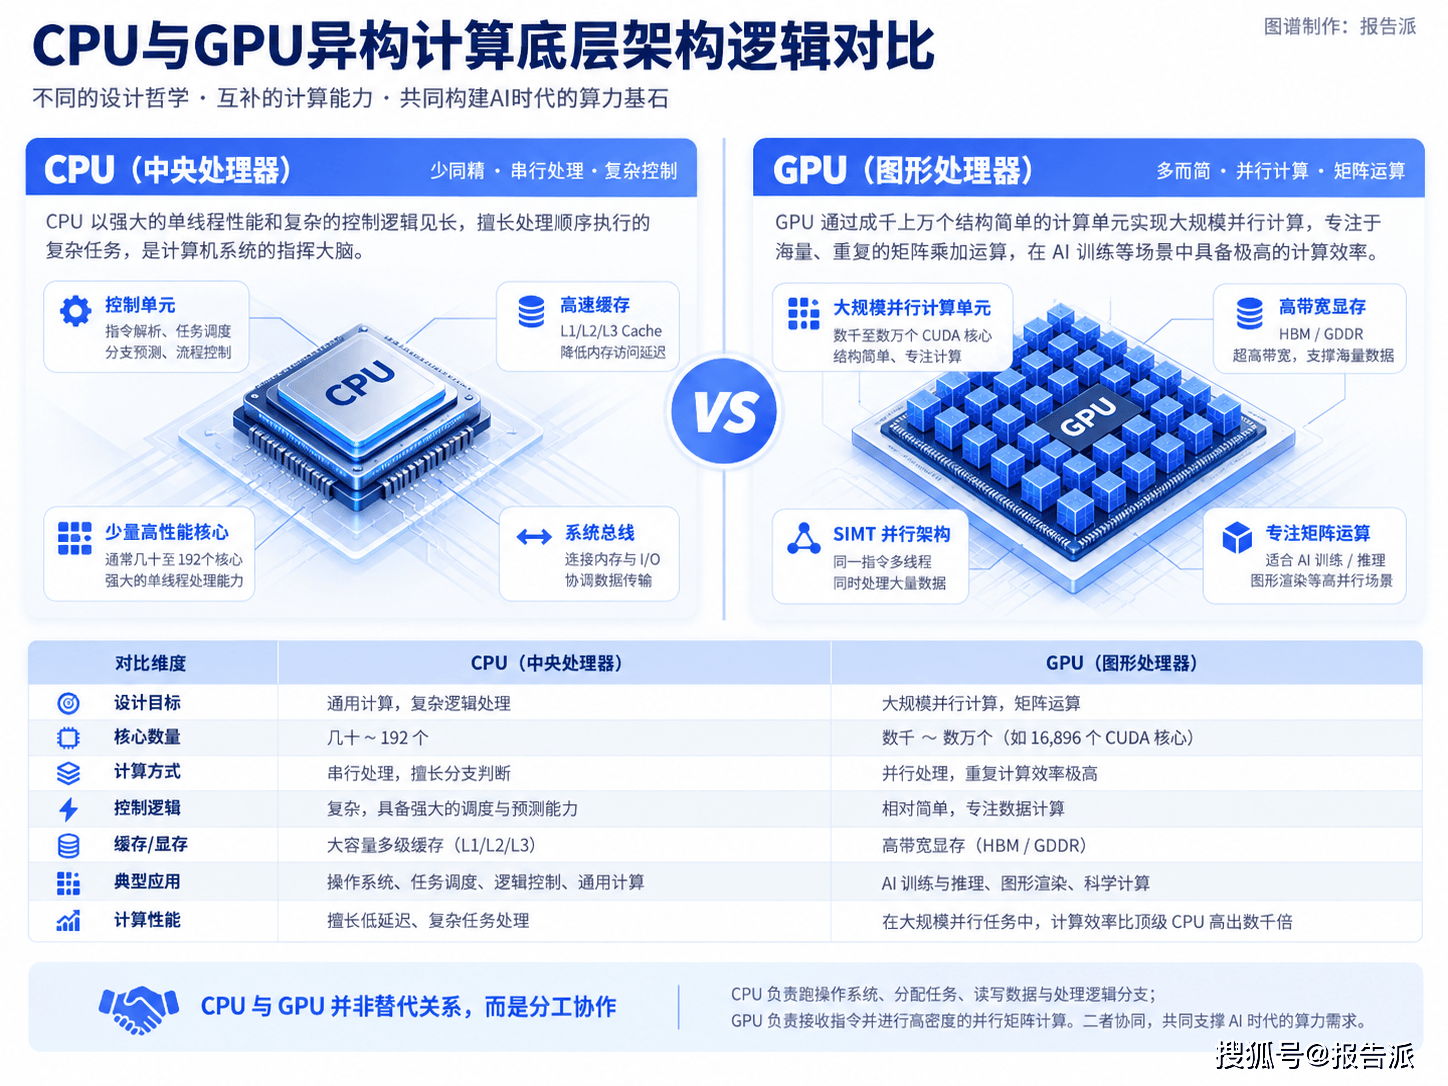
CPU(中央处理器)被称为计算机的指挥大脑,其设计哲学是“少而精”。以旗舰级服务器芯片为例,单个 CPU 的核心数量通常在几十至 192 个左右,但每个核心都具备极强的单线程逻辑判断、复杂分支预测与全局调度能力。简单来说,CPU 什么活都能干,但同一时刻只能处理少数高难度的逻辑任务。
GPU(图形处理器)则走向了另一个极端,其设计哲学是“多而简”。GPU 早期为了应对屏幕上数百万像素点的并行图形渲染,像素点的颜色计算互不依赖,可以同时进行。因此 GPU 放弃了复杂的控制逻辑,堆叠了数万个结构简单的计算单元。
以英伟达 Blackwell 架构芯片为例,单颗芯片集成了多达 16896 个 CUDA 核心。在大模型训练场景下,本质是海量重复的矩阵乘加运算,这使得 GPU 的并行计算效率比顶级 CPU 高出数千倍。
二者并非替代关系,而是分工协作:CPU 负责跑操作系统、分配任务、读写数据与处理逻辑分支;GPU 负责接收指令并进行高密度的并行矩阵计算。
02.
行业分类复杂控制与并行计算的分流

在当前半导体产业的分类体系中,通用算力芯片主要依据架构指令集与计算任务形态进行划分。
从指令集架构与控制逻辑划分,CPU 形成了 x86、ARM 和开源 RISC-V 三大阵营:
x86 架构凭借深厚的软件生态主导传统服务器与 PC 市场;
ARM 架构以高能效比统治移动端,并正在数据中心领域快速渗透;
RISC-V 则在特定物联网与定制化计算场景中崛起。
从作业形态与计算任务划分,GPU 清晰地分化为桌面级图形显卡与通用计算加速卡(GPGPU):
桌面级显卡面向图形渲染、游戏与消费级应用,兼顾显示输出功能;
GPGPU 则彻底撕去了“图形”标签,去除了显示输出电路,专精于深度学习训练与推理。
此外,随着算力需求向边缘端和特定场景延伸,AI 加速芯片也衍生出训练一体卡、推理专用卡以及融合了 CPU-GPU 统一内存架构的系统级机柜方案。
03.
发展历程从图形渲染到计算协同的演进

运算芯片的发展史,实质上是一场计算范式与物理极限博弈的演进史。
早期阶段,CPU 遵循摩尔定律与登纳德缩放定律,通过提升主频与单核性能统治了计算世界。但随着物理热壁垒的显现,单核主频遭遇瓶颈,算力发展迫转向多核并行化。
同一时期,GPU 借由图形渲染的蓬勃发展迅速崛起。2006 年通用计算架构 CUDA 的问世是芯片历史上的关键转折点,它第一次让开发者能够用高级语言直接调用 GPU 的并行计算能力,使 GPU 从单纯的显示工具演变为通用计算平台。
2022 年大模型爆发后,算力需求进入指数级膨胀阶段。GPU 显存容量与带宽拉开军备竞赛,先进封装(CoWoS)与高带宽内存(HBM)成为标配。
而当生成式 AI 从简单的对话问答升级到具备自主决策能力的智能体(Agent)阶段时,运算模式再次发生嬗变。依靠 CPU 处理操作系统虚拟化、调度无头浏览器与长上下文管理的复杂逻辑,再次将行业推向了“CPU+GPU 异构协同”的新时代。
04.
产业链全景分析高门槛的全球分工协作
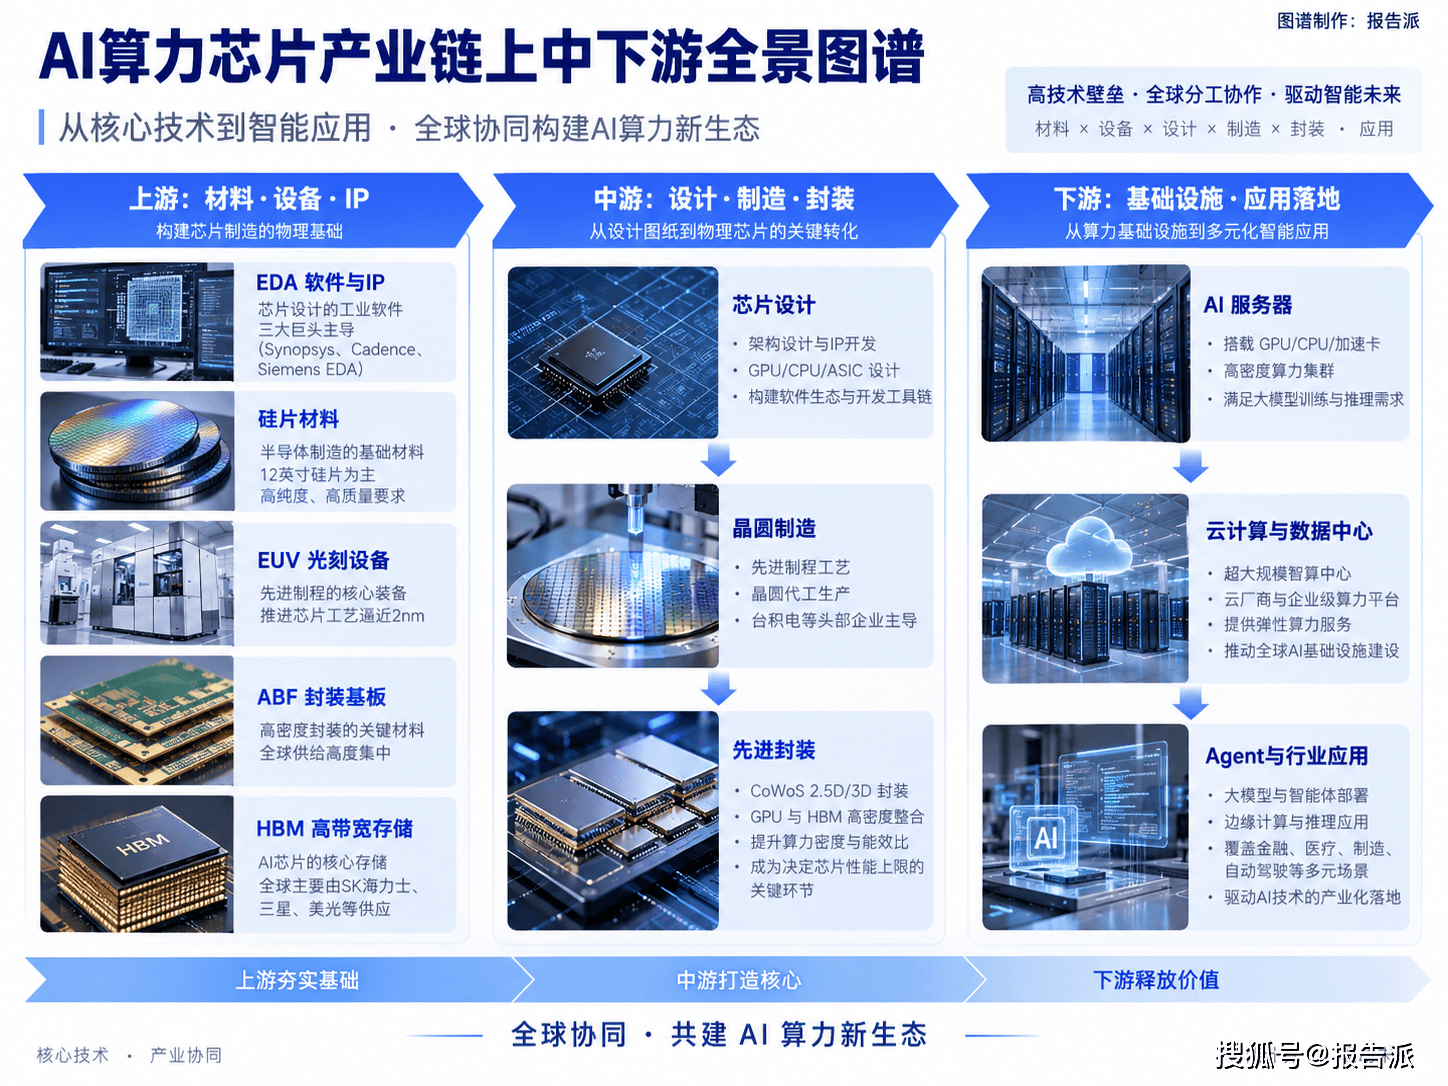
CPU 与 GPU 产业链是全球半导体工业精密协作的极致体现。整条产业链横跨基础科学、工业软件、精密设备与制造封测,呈现出高资本开支、高技术壁垒与寡头垄断的特征。
上游分析:材料、设备与存储屏障
上游供给构成了芯片制造的物理基础。首先是 EDA 工具与 IP 授权,国际三大巨头垄断了全球超八成的 EDA 市场。其次是关键设备与材料,极紫外光刻机(EUV)、薄膜沉积与刻蚀设备是推进芯片工艺逼近 2nm 的核心前提。在封装材料环节,ABF(味之素堆叠膜)材料构成了绝大多数高密度载板的绝缘基础,全球 95% 以上的供给依赖日本味之素公司。另一个重度依赖的上游环节是 HBM(高带宽存储),全球 HBM 产能主要被 SK 海力士、三星与美光三大巨头瓜分。
中游分析:设计架构与先进封装的撕扯
中游涵盖了芯片从设计图纸到物理实体的关键转化环节。在芯片设计领域,英伟达与 AMD 在通用 GPU 领域占据了绝大多数市场份额,其建立的 CUDA 及软件生态构成了难以逾越的护城河。晶圆代工制造环节,台积电在先进制程上拥有绝对主导力。随着物理制程逼近原子尺寸,单靠缩减晶体管尺寸提高性能的成本过高,中游的焦点正急剧向先进封装转移。以 2.5D/3D 封装为代表的 CoWoS 技术,将 GPU 裸片与 HBM 芯片高密度整合在一起,成为了决定大模型芯片算力上限的核心制造关口。
下游分析:从大模型训练到 Agent 的应用扩散
下游基础设施建设与应用落地直接倒逼中上游的产能分配。AI 数据中心是当前最庞大的下游拉动引擎。随着应用层从纯粹的大模型训练向边缘端推理、Agent 智能体部署延伸,基于自主智能体的工作流需要为每个并发用户建立独立的沙盒运行环境,对于系统的虚拟化管理、内存吞吐和存储并发提出了极高要求。这不仅推升了数据中心对高密度 DRAM 和存储接口芯片的需求,也直接改写了下游数据中心的服务器采购硬件配比。
05.
相关企业与三条核心变革主线
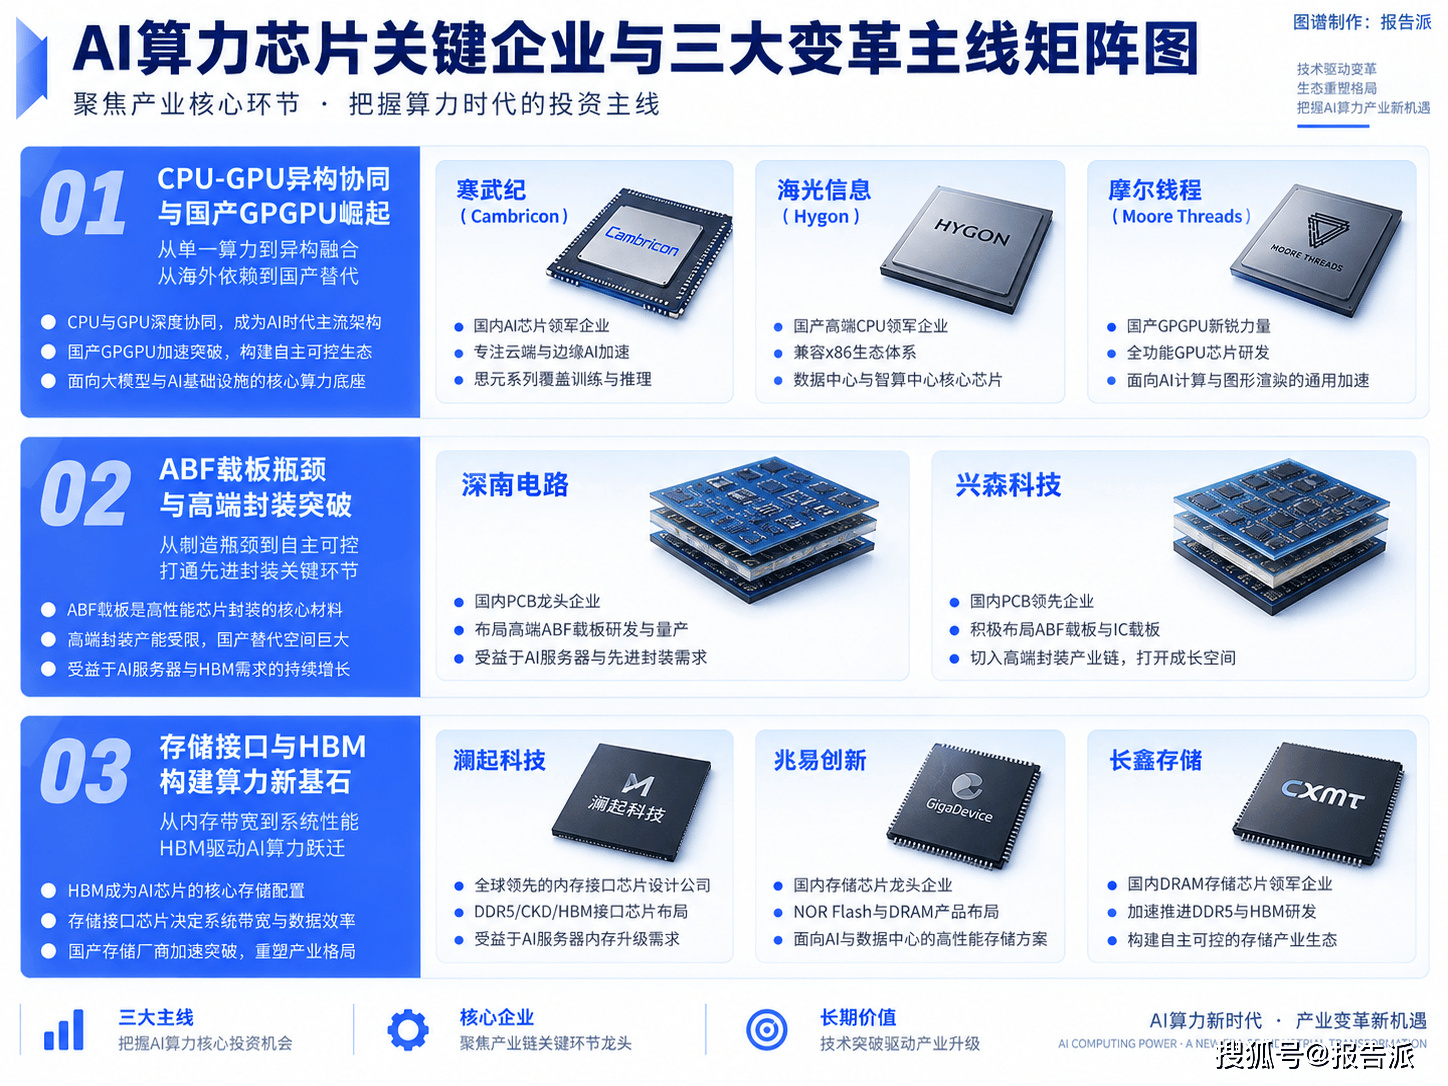
在产业链重组与算力范式交替的过程中,行业正孕育出三条极为确定的边际变革线索:
主线一:算力协同演进与国产替代格局
算力负载由 GPU 单边消耗转变为“CPU+GPU 异构协同”。当 Agent 架构全面落地,几十亿消费级用户带来的高并发调度,将带来百万级的 CPU 增量需求。全球市场上,具备 CPU 与 GPU 复合设计能力的厂商显著受益。
而在本土市场,受外部环境与本土生态发展的双重驱动,算力芯片的国产化正在提速。国内通用 GPU 市场此前长期由国际龙头主导,随着海光信息、寒武纪、摩尔线程、沐曦、天数智芯等本土头部厂商在产品迭代与软件生态上的突破,国产通用算力芯片渗透率有望迎来显著提升。
主线二:ABF 载板成为核心制造瓶颈
ABF 载板是连接超大规模芯片与 PCB 主板的关键桥梁。芯片触点数以万计且间距极小,必须依赖 ABF 载板实现信号中转、供电与散热支撑。随着芯片封装面积放大 5 到 10 倍,单芯片耗用的载板面积成倍增长。
供给端方面,全球揖斐电、欣兴等龙头制造厂商的高端产能被头部科技巨头长期锁定,服务器 CPU 载板的产能紧缺导致价格进入上行通道。深南电路、兴森科技等国内载板厂商正在迎来绝佳的本土替代与产能填补窗口。
主线三:存储瓶颈与接口芯片的量价齐升
Agent 工作流维持多轮工具调用状态和长周期上下文,使得内存带宽与 KV Cache 吞吐成为新的性能堵点。单台 AI 服务器部署的 DDR5 内存模组数量远超传统服务器,直接带动了内存接口芯片的规格迭代与量价齐升。
如澜起科技在 DDR5 RCD 接口芯片领域的持续迭代,显著受益于这一结构性红利。与此同时,存储模组厂商(如兆易创新、江波龙、佰维存储、德明利)也随着存储周期的回暖与需求爆发改善了业绩。高带宽存储(HBM)的国产化研发也在提速,长鑫存储等本土存储大厂在 HBM 领域的进展,正成为推动整条产业链国产化下半场的关键催化剂。
06.
边界与思考迁徙的系统瓶颈与硬考验
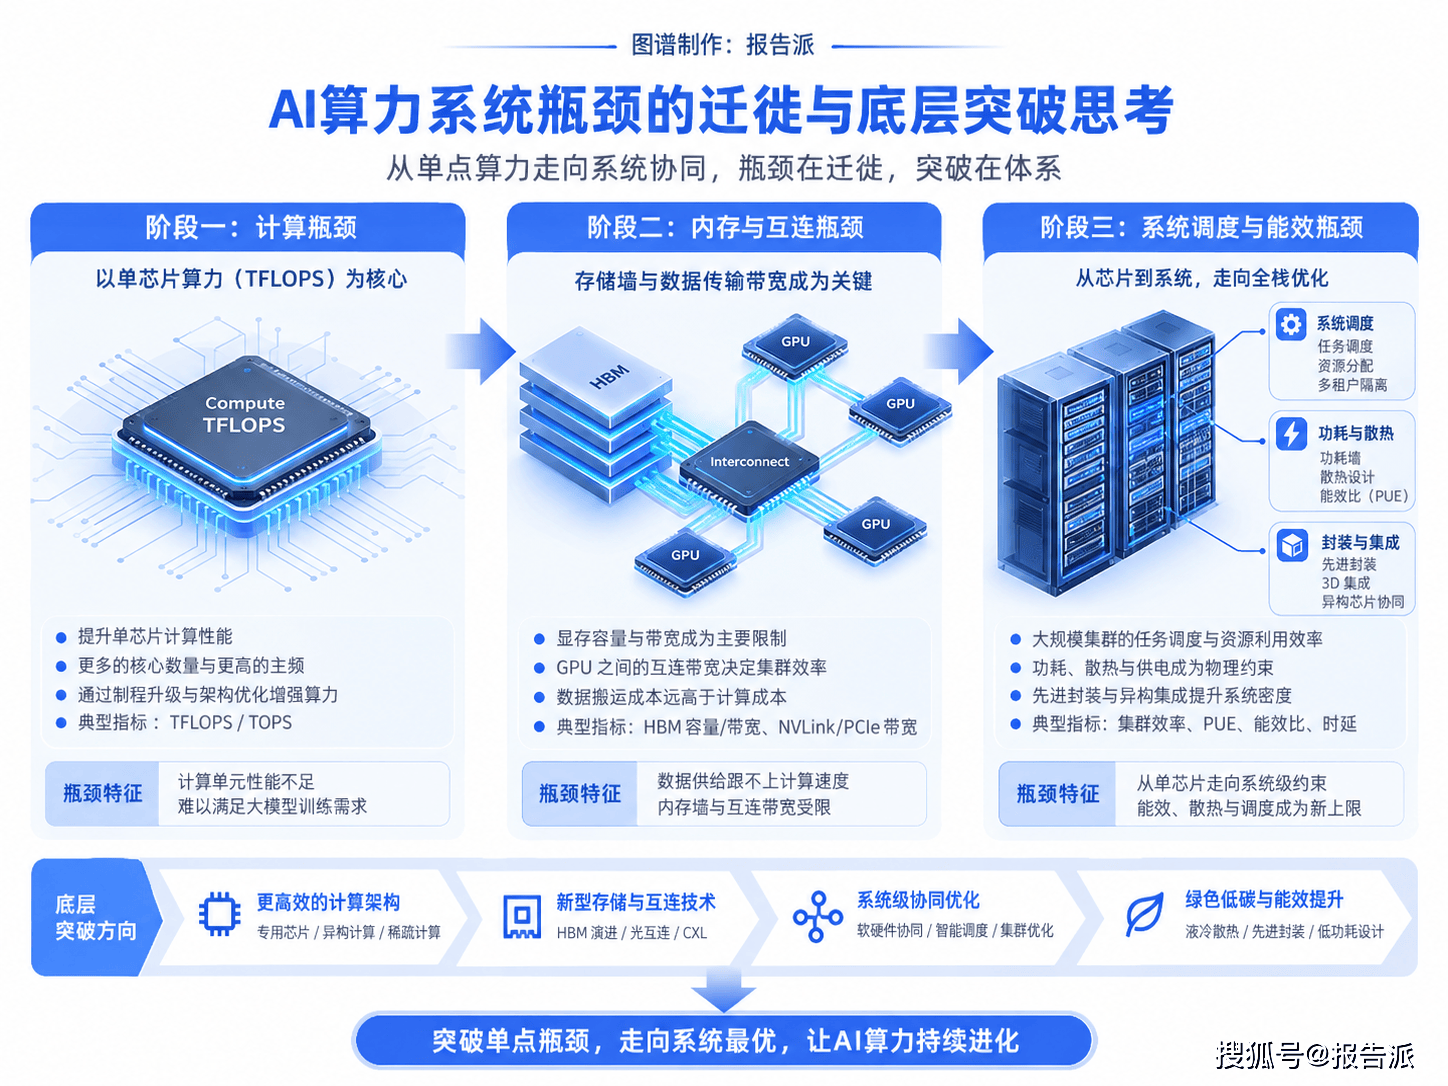
算力产业的演进从来不是单一芯片能力的盲目堆叠,而是系统工程与商业效益的平衡。
当下 CPU 产能的供需失衡与架构地位反弹,揭示了一个朴素的半导体规律:没有孤立的算力奇迹,只有不断迁徙的系统瓶颈。
当 GPU 解决了天量数据“算得快”的问题后,如何让数据“调度得好”、“传输得通”、“存储得下”,重新成为了制约产业落地的核心命题。
长期来看,当先进封测的产能极限与物理制程成本天花板逼近,全球 AI 基础设施建设是否会因供应链中某一材料或接口的阻滞而陷入阶段性停顿?这将是未来数年内,整个半导体产业链必须面对的硬考验。














