

这次我换了个办法。不看二手报道,直接去各大厂商的官网核实。GPT、Claude、Gemini、DeepSeek、智谱、通义、Kimi、豆包,一个个查下来,把版本号、发布日期和核心能力都记下来。再结合我自己每天使用的体感,加上社区和论坛里大家试出来的玩法,整理成这份清单。
国际大模型现在能做什么
OpenAI的GPT-5.6是7月9日发布的,分Sol、Terra、Luna三个层级。8月初更新以后,免费用户的文字聊天不再限次了,还增加了可调思考强度的功能。旗舰版Sol在电脑操作测试OSWorld 2.0上拿到62.6%,这个成绩目前在同类测试里排第一。
Anthropic的动作更早。6月9日就发布了Claude Fable 5,这是他们公开的最强通用模型。100万token上下文,单次最大输出128k token。在软件工程测试SWE-Bench Pro上拿到80.3%,超过了GPT-5.5。Stripe用它一天完成了5000万行Ruby代码库的迁移,原来需要一个团队干两个多月。后来7月24日又发布了Opus 5,性能逼近Fable 5,价格只要一半,所以现在用Opus 5的人更多。我平时用Claude写代码比较多,Opus 5发布以后,复杂任务的完成度上了一个台阶。
Google的Gemini 3系列,最新稳定版是3.6 Flash。它能同时处理文字、图片、视频和音频,带Agent能力,也能写代码。Google还有几个独立的Agent模型,Veo 3.1做视频生成,Computer Use做电脑操作,Deep Research做深度研究。
国内大模型现在能做什么
国内这一波更新更快。
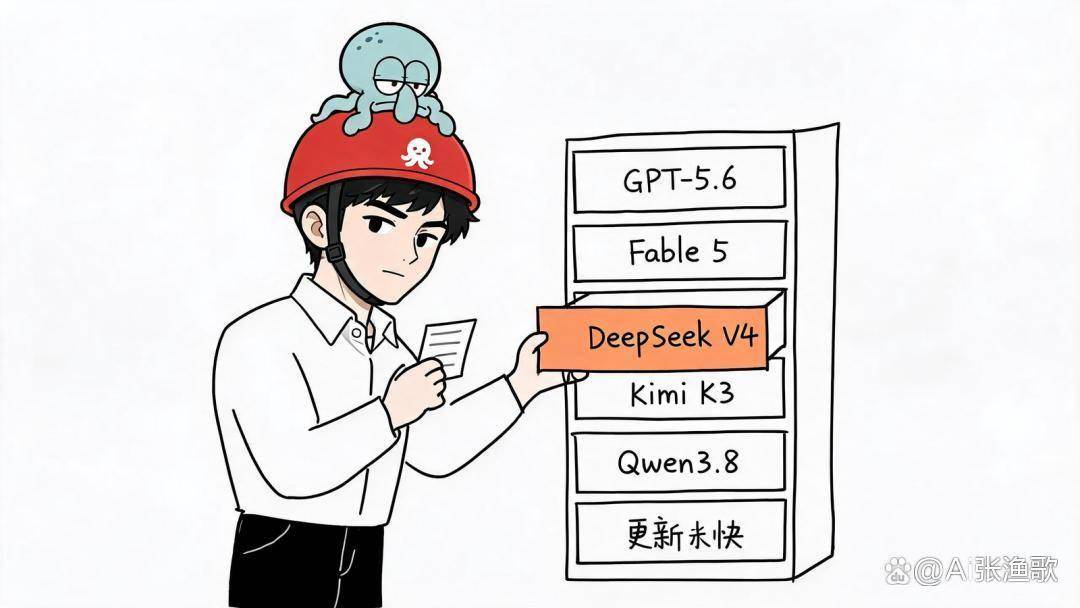
DeepSeek V4是4月发布的,分Pro和Flash两个版本。Pro有1.6万亿参数,Flash有2840亿参数,支持100万token上下文,完整开源。7月31日,Flash版开放了API公测,增强了Agent能力。我自己经常用DeepSeek,免费版日常写东西已经够用。有开发者算过一笔账,用DeepSeek写一篇3000字的文章,消耗约5000个token,成本不到一分钱。
智谱的GLM系列在6月发布了开源旗舰GLM-5.2,在HuggingFace开源排行榜上登顶。编程测试HumanEval+拿到了95.7%,超过了GPT-5.5的93.2%。智谱官方API平台同时提供GLM-5.1旗舰版。另外智谱的AutoGLM能直接操作手机,帮你点外卖、订机票,这个能力放在半年前还觉得很科幻。
阿里通义千问8月3日刚发布了Qwen3.8-Max,2.4万亿参数,基于Qwen 3.5架构,是Qwen家族至今最强的模型,也是首次开源Max级权重。官方说主打编程和协作能力。同期还发布了Qwen-Image-3.0图像模型、AgentWorld语言世界模型和Robot Suite机器人基础模型。
月之暗面7月16日发布了Kimi K3,2.8万亿参数,是目前全球最大的开源模型。MoE架构,896个专家每次激活16个。100万token上下文,原生视觉多模态理解。Arena榜单进了全球前三,前端开发榜拿了世界第一。K3还能在沙箱里连续自主工作15小时。不过K3自己也承认,整体用户体验还落后于最强的闭源模型。K2.5会在8月31日下线。
豆包大模型的产品线是最全的。持续进化的编程Agent旗舰、视觉理解模型、30秒视频生成、实时语音对话、同声传译、音乐生成,都有。日均token使用量120万亿,这个数字能看出用的人有多少。
按能力分类,AI到底能做什么
把上面这些模型的能力归一归,大概分这几类。社区和论坛上大家试出来的真实玩法,我也一并写进来。
文字对话与理解
所有大模型都能聊天、回答问题、写文章、做翻译、总结文档。免费版已经能处理大部分日常文字工作。100万token的上下文意味着你能丢一整本书进去让它读。
写代码与编程
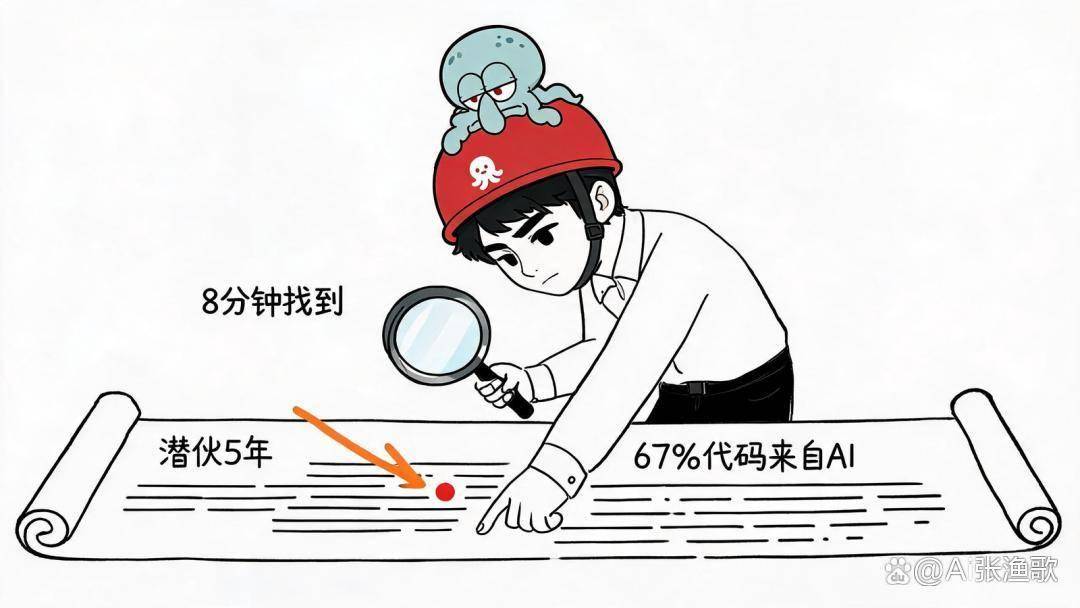
Claude Code在2026年的横评中拿了9.2分,Cursor 8.8分,GitHub Copilot 7.5分。阿里云甚至给自家的AI编程工具通义灵码分配了正式员工工号AI001。社区里有人详细记录了一个月的使用数据,67%的代码提交来自AI,平均每天省3.2小时,一个月省了约70小时。还有一次更夸张,有人把硬件钱包Coldcard的代码丢给Claude,8分钟就找到了一个潜伏5年的安全漏洞,之前团队自己查了十几遍没查出来。我写代码主要靠Claude,复杂项目的完成率比半年前高了很多。
操作电脑和手机
现在至少有三款工具能直接操作你的电脑。Anthropic的Computer Use、智谱的AutoGLM和GLM-PC、OpenAI的Operator,能像人一样点鼠标、打字、填表格。有人实测AutoGLM操作手机,让它“打开抖音搜索某个博主并关注”,全程17秒完成,没有人工干预。还有人用ToDesk的AI功能同时操控4台电脑,分别负责竞品调研、数据分析、设计渲染和邮件检查。开源工具Cua在GitHub上拿了19.5K Star,完全免费。
多模态理解
就是看图、听音、看视频。Gemini 3.6 Flash和Kimi K3都带原生视觉理解,你发一张图过去,它能告诉你图里有什么。语音方面,豆包有实时语音对话和同声传译模型。
视频生成
豆包的Seedance 2.5能生成30秒视频。MiniMax H3在7月31日发布,8月3日开源,支持2K分辨率原生直出,15秒视频带原生立体声音轨,价格0.8元一秒。有人用豆包写剧本,用即梦Seedance生成分镜画面,半小时做出一条60秒10镜头的古风短剧,台词和配音都是AI自动生成的。
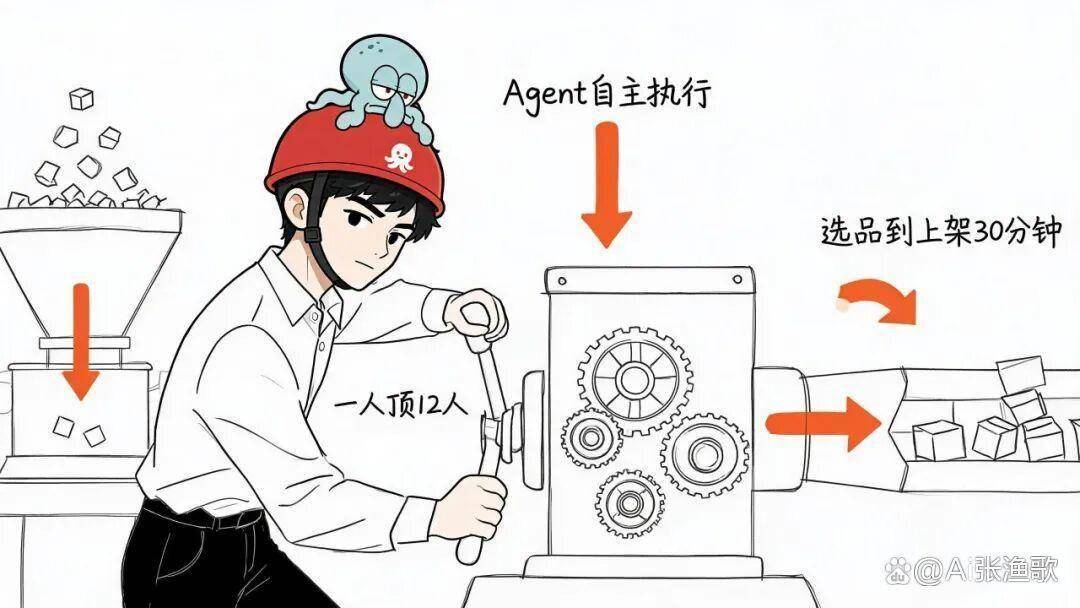
Agent自主执行
按岗位分类,谁能用上
程序员就不用说了,AI编程工具已经是标配。写代码、读代码、查BUG,效率提升非常明显。
金融岗,华兴银行的AI信贷助手把尽调报告从10天压缩到了1天。
内容岗,写文章、做配图、剪视频,AI都能参与。我自己写公众号就是AI辅助全流程。
研究岗,Gemini的Deep Research能自动做多步搜索和整理,GPT-5.6也能做深度研究。
运营岗,数据分析、用户画像、内容排期,AI都能搭把手。
新模型跟旧模型
模型更新很快。光是2026年夏天,Qwen3.8、GPT-5.6、Kimi K3、GLM-5.2,好几个新版本扎堆发布。但旧版本在大多数场景照样能干活。
我自己同时用好几个不同版本的模型。写日常文字用免费版就够了,复杂推理才需要旗舰版。按场景选模型,别被版本号绑架。有些新能力确实只有新版本支持,比如GPT-5.6的可调思考强度、K3的原生视觉理解。安全敏感场景,还是用经过充分验证的版本更放心。
Agent能做到什么程度
Agent是今年最被看好的方向,但我得说句实话。
在107个真实业务任务的评测中,目前最强的AI Agent组合也只完成了大约六成,通过率56.1%。同一个模型换一套工程框架,成绩能差11.3个百分点。
调研机构Gartner预测,2026年超过六成的企业自动化流程会融入AI Agent。但预测不等于已经实现。
Agent在简单重复任务上已经可用,在复杂场景中还有不小的失败率。把它当成万能的,失望会来得很快。把它当成一个需要调教和配合的助手,体验会好很多。
最后说几句
以上列出的,是截至2026年8月9日,我从各大官网核实的数据,加上社区里各位玩家实际试出来的玩法,再结合我自己每天使用的体感整理出来的。仅代表个人意见,大家可以自行探索。
不用一上来就追求最新最强的模型。挑一个你觉得有意思的能力,找对应的免费版试一次。写一篇文章也好,让AI帮你整理一次会议纪要也好,生成一段视频也好。用过了,你才知道这些能力跟你的工作到底有没有关系。
我是张渔歌,1999年生,国企辞职青年,AI Agent 探索者。这里不吹概念,只记录一个普通人如何从零理解、使用并真正驾驭 AI Agent。
数据来源:OpenAI、Anthropic、Google、DeepSeek、智谱、通义千问、月之暗面、火山引擎等官方平台;社区案例来自CSDN、掘金、今日头条等平台用户实测。截至2026年8月9日。















