

摘要:大语言模型工业化落地进程中,推理显存利用率低、批处理吞吐受限、长序列推理成本高昂、GPU资源碎片化等问题,长期制约着大模型规模化服务部署的效率与经济性。传统推理框架受限于连续内存分配机制与静态批处理策略,普遍存在显存浪费严重、并发能力弱、长文本推理卡顿等工程痛点。vLLM作为基于PagedAttention分页注意力机制的高性能开源推理引擎,创新性将操作系统虚拟内存分页思想引入大模型KV缓存管理,配合连续批处理调度、动态显存回收、前缀缓存共享等核心技术,彻底重构了大模型推理的内存与算力调度逻辑。相较于FasterTransformer、Orca、原生Hugging Face推理方案,vLLM可将KV缓存内存浪费率从60%–80%压缩至4%以内,推理吞吐量提升2–4倍,同时兼容全系列开源模型与轻量化部署场景。本文从核心技术原理、性能优势、生态适配能力、行业落地价值、现存局限五个维度系统剖析vLLM成为开源大模型项目标配组件的底层逻辑,为大模型工程化部署、推理框架选型与规模化服务搭建提供学术依据与工程参考。
关键词:vLLM;PagedAttention;大模型推理加速;KV缓存;连续批处理;模型服务化部署
一、引言
随着Llama、Qwen、Mistral、LLaVA等开源大模型生态持续完善,大模型应用开发从模型预训练、微调研发阶段,全面转向规模化服务部署与场景化落地阶段。推理性能、显存利用率、服务吞吐与部署成本,逐渐替代原生模型基准分数,成为衡量大模型工程落地价值的核心指标。传统大模型推理体系采用静态连续内存分配方案,KV缓存需预先申请整块连续显存,不同推理请求的缓存空间相互独立、无法复用,推理结束后内存释放碎片化严重,导致高端GPU算力长期处于低负载状态,资源利用率不足30%。同时,静态批处理机制需等待批次凑齐后统一推理,存在大量算力空窗期,长序列文本推理场景下显存溢出、服务卡顿、请求超时问题频发。
在行业亟需高效推理基础设施的背景下,vLLM凭借颠覆性的PagedAttention内存管理架构与轻量化高性能服务能力,突破传统推理框架的技术瓶颈,凭借极致的吞吐性能、极低的部署门槛、全模型兼容、开源生态友好等优势,快速成为RAG知识库、本地部署工具、智能体框架、云端模型服务等开源项目的标配推理组件。目前主流开源大模型应用项目、企业级模型服务平台、边缘推理系统均已完成vLLM适配,形成行业统一部署标准。本文深度拆解vLLM的核心技术创新,量化分析其性能优势与生态优势,阐明其行业普及的底层逻辑,并梳理技术局限与迭代方向。
二、vLLM核心技术原理与架构创新
vLLM并非简单的推理参数调优工具,而是一套重构KV缓存管理与请求调度逻辑的全新推理服务架构,其核心竞争力来源于PagedAttention分页注意力机制与连续批处理调度两大底层创新,从内存利用与算力调度两个维度解决传统推理的核心痛点。
2.1 PagedAttention分页注意力核心机制
传统大模型推理的核心资源损耗来源于KV缓存的不合理分配。大模型迭代推理过程中,每一轮Token生成都会产生对应的Key、Value缓存数据,传统框架要求KV缓存占用连续物理显存空间,不同序列的缓存无法拆分、复用,短序列请求会预留大量闲置显存,形成严重的内存空洞,整体显存浪费率高达60%–80%。vLLM创新性借鉴操作系统虚拟内存分页机制,提出PagedAttention算法,将KV缓存统一拆分为固定大小的独立显存块,通过块映射表建立逻辑序列与物理显存块的关联关系,无需连续内存即可完成注意力计算。
该机制实现了显存资源的精细化按需分配,彻底消除大块内存碎片化问题,将KV缓存内存浪费率控制在4%以内,显存利用率提升至95%以上。同时,PagedAttention支持多请求间前缀缓存共享,不同用户相似提问、同源文本的重复前缀序列可复用同一组显存块,大幅减少重复计算与内存占用,尤其适配批量相似业务请求、长文档重复段落推理场景,显著提升推理效率。区别于FlashAttention侧重计算加速的优化逻辑,PagedAttention聚焦存储层极致优化,二者可协同叠加,同时实现计算高效性与内存高利用率。
2.2 连续批处理动态调度机制
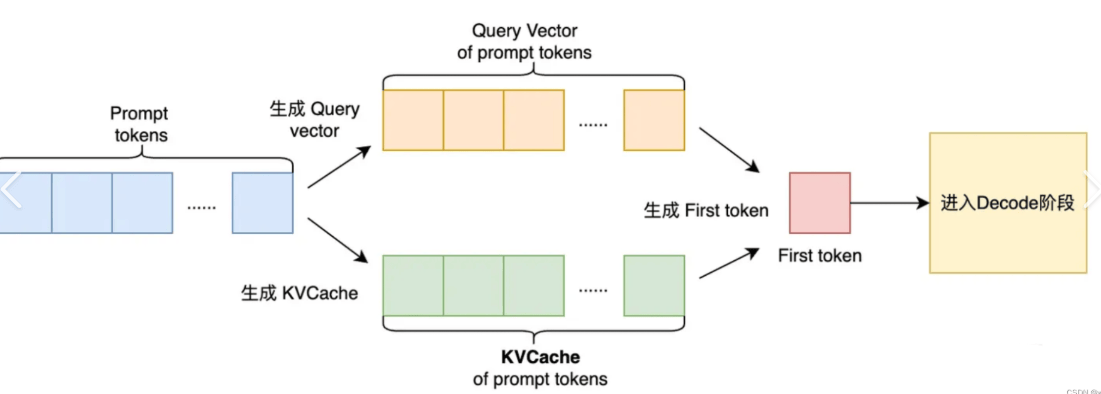
传统推理框架采用静态批处理模式,需等待批次填满或超时后统一执行推理,新请求只能等待下一轮批次,算力空闲损耗大、响应延迟不稳定。vLLM搭载自研连续批处理调度策略,摒弃固定批次更新逻辑,在每一个解码步动态接纳新请求、剔除<div id="kuaicai-mro.com0649">已完成请求,实现请求批次的实时迭代更新。该机制无需人为设置批处理参数,可根据实时请求量、序列长度、设备算力动态适配批次规模,最大化填充GPU算力空缺,彻底解决静态批处理的算力闲置问题。实测数据显示,连续批处理机制可让GPU有效算力利用率提升一倍以上,高并发场景吞吐优势尤为突出。
2.3 轻量化架构与全生态兼容设计
vLLM采用轻量化模块化架构,无冗余依赖、部署简洁,原生兼容主流开源大模型,涵盖文本大模型、多模态模型、代码模型、长文本专精模型,支持FP16、INT8、INT4等多精度量化推理,可适配GPU云端部署、本地服务器部署、边缘算力部署等多场景。同时,vLLM完全兼容Hugging Face生态接口,原生支持OpenAI格式API调用,开发者仅需少量代码修改即可完成推理引擎替换,迁移成本极低。此外,框架支持分布式推理、模型热更新、动态显存扩容、请求抢占调度等企业级能力,兼顾轻量化易用性与工程级稳定性,完美适配开源项目轻量化开发与规模化迭代需求。
三、vLLM核心性能优势与横向对比
为明确vLLM的行业竞争力,本文结合主流推理框架开展横向性能对比,从显存利用率、推理吞吐、响应延迟、长序列适配、并发稳定性五个维度量化分析其核心优势。对比对象包括原生Transformers、FasterTransformer、llama.cpp三类主流推理方案,覆盖个人开发、企业部署、本地推理全场景。
3.1 显存利用率与并发承载优势
得益于PagedAttention分页缓存机制,vLLM实现了近乎极致的显存利用效率。传统框架单卡GPU仅能承载数十条并发请求,且长序列场景极易显存溢出;vLLM通过显存块复用、碎片回收、前缀缓存共享,单卡并发承载量提升3–5倍,同等硬件条件下可支撑更多推理任务,硬件性价比大幅提升。在128K超长上下文推理场景中,传统框架显存占用呈指数级增长,难以稳定运行,而vLLM可通过动态分页分配精准控制显存开销,长序列推理稳定性远超同类框架。
3.2 推理吞吐与延迟性能优势
多项权威基准测试表明,在同等硬件与模型条件下,vLLM的整体推理吞吐量较FasterTransformer提升2–4倍,较原生Transformers提升5–8倍。在短文本高并发场景中,连续批处理机制大幅压缩算力空窗期,平均推理延迟降低30%以上;在<div id="yousandou.com1642">长文本批量处理场景中,显存复用优势进一步放大,吞吐提升效果更为显著。同时,vLLM的P99延迟稳定性远优于传统框架,高负载场景无剧烈延迟抖动,服务稳定性更强。
3.3 部署与迁移成本优势
相较于FasterTransformer部署复杂、适配难度高、小众模型兼容性差的问题,vLLM开箱即用、适配性广、迁移成本极低,完全契合开源项目轻量化、快速迭代、易部署的开发特性。对于绝大多数开源RAG项目、智能体框架、本地部署工具,替换vLLM推理引擎无需重构核心代码,即可实现推理性能数倍提升,投入产出比极高,这是其快速普及的核心工程优势。
四、vLLM成为开源标配的核心原因
4.1 技术层面:解决行业通用工程痛点
当前绝大多数开源大模型项目的核心痛点并非模型能力不足,而是推理效率低、硬件成本高、服务稳定性差。vLLM精准命中显存碎片化、算力利用率低、长序列推理不稳、并发能力弱四大通用痛点,以底层架构创新实现性能跨越式提升,且不依赖高端专属算力,在消费级GPU、中端服务器显卡上均可发挥显著优化效果,具备普适性技术价值。
4.2 生态层面:零门槛适配全场景开源项目
vLLM极致的兼容性与易用性,使其能够快速融入各类开源生态。无论是轻量化本地部署项目、RAG知识库系统、AI智能体框架,还是云端模型服务平台、批量数据处理工具,均可快速适配vLLM推理加速能力。同时,项目开源协议宽松、社区迭代活跃、文档完善、问题修复高效,为开发者提供了稳定可靠的技术支撑,契合开源项目共建共享、快速迭代的发展逻辑。
4.3 产业层面:大幅降低大模型落地成本
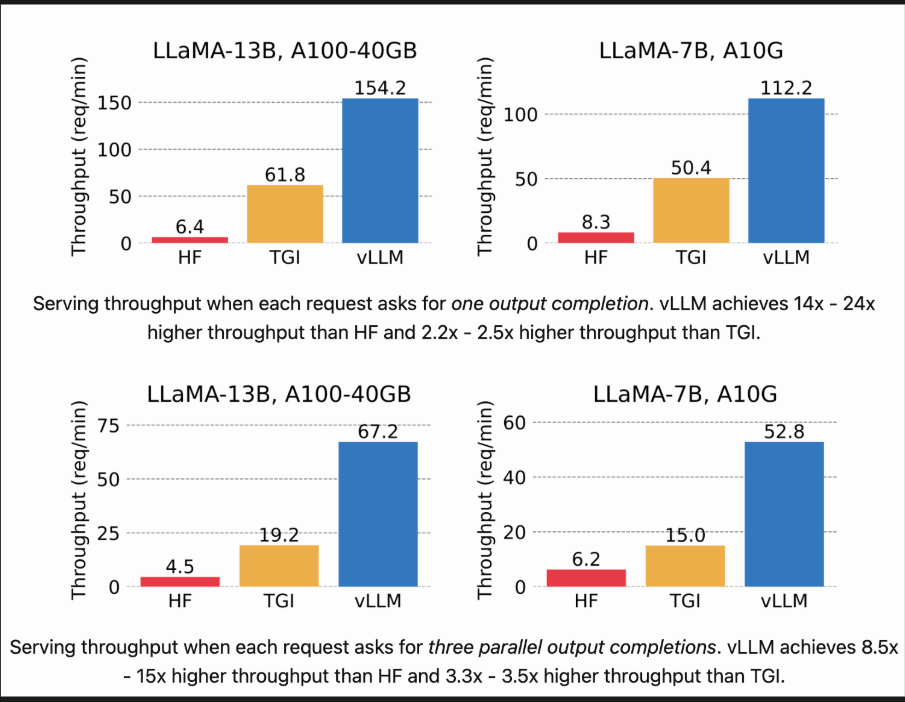
大模型规模化落地的核心瓶颈为算力成本过高。vLLM通过极致的显存与算力优化,在不升级硬件的前提下大幅提升服务吞吐,同等业务量下可减少50%以上的GPU算力投入,显著降低企业部署成本与个人开发门槛。在普惠AI落地的产业趋势下,高性价比、高性能的vLLM自然成为各类开源项目的最优推理底座。
五、vLLM现存局限与优化边界
作为通用推理加速引擎,vLLM仍存在明确的场景适配边界。首先,极致训练场景优化不足,框架核心聚焦推理服务,模型训练、微调场景的加速能力弱于专业训练框架,无法替代训练专用架构。其次,超轻量化边缘终端适配有限,针对嵌入式、低功耗微型边缘设备,框架体积与资源调度仍有优化空间,极致端侧部署不如llama.cpp轻量化。最后,极复杂多模态推理适配有待完善,部分小众多模态模型的图文联合推理优化不足,相较于定制化推理框架存在小幅性能差距。
同时,在超高并发、超大规模分布式集群场景中,vLLM的原生负载均衡、故障自愈能力弱于企业级商用推理引擎,需要二次开发优化方可适配超大型云端服务场景。但对于99%的开源项目、中小企业部署、个人开发、常规云端服务场景,其性能与稳定性完全满足需求,短板不影响通用场景的标配地位。
六、结论
vLLM凭借PagedAttention分页注意力机制与连续批处理调度的底层技术创新,从根本上解决了传统大模型推理显存碎片化、算力利用率低、并发能力弱、长序列不稳的行业痛点,实现了推理吞吐、显存效率、服务稳定性、部署成本的多维<div id="delholding.com2914">最优平衡。其全模型兼容、低迁移门槛、轻量化部署、社区生态完善、性价比极高的核心特性,完美适配各类开源大模型项目的开发与落地需求,成功替代传统推理方案,成为当前开源领域通用的推理加速标配组件。
尽管在极致训练、超轻量化端侧、超大型集群部署等细分场景存在局限,但在主流模型服务、开源应用开发、轻量化工程落地场景中,vLLM的综合性能与易用性处于行业顶尖水平。未来随着框架持续迭代,多模态推理优化、分布式调度升级、边缘端轻量化适配将进一步完善,vLLM将持续巩固其大模型推理基础设施的核心地位,推动大模型工程化落地向高效化、低成本化、普惠化方向深度演进。















