

智猩猩AI整理
编辑:林夕
刚刚,Z.ai发布文章《Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure》。
披露了GLM-5.3-Flash在国产芯片集群上的推理基础设施建设过程。
同时,智谱将这项工作放在“Recursive Self-Improvement(递归自我改进)”的框架下讨论,但并没有宣称已经实现RSI。
文章直接写道:
We have not yet reached recursive self-improvement.
但一个很小的闭环已经出现了:GLM优化运行自己的系统,而这个系统又服务GLM。
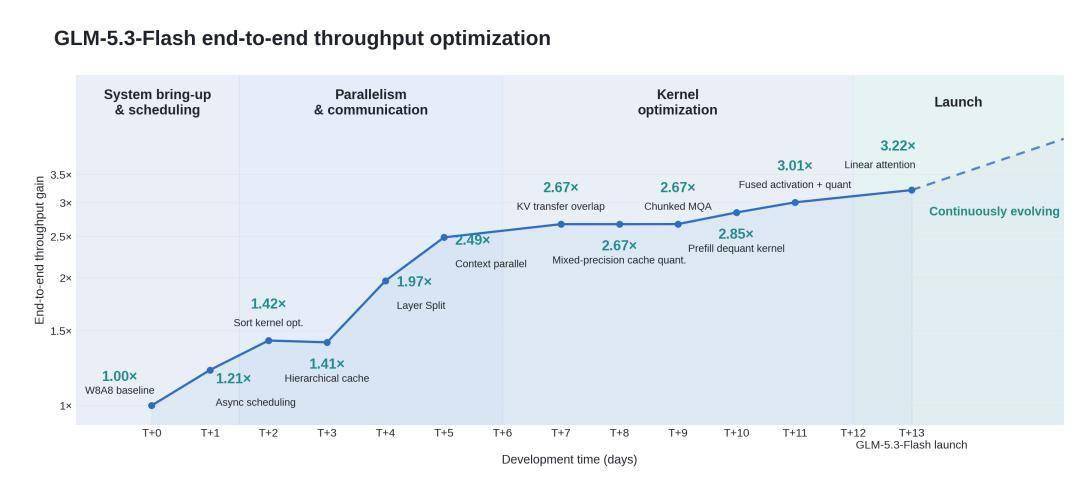
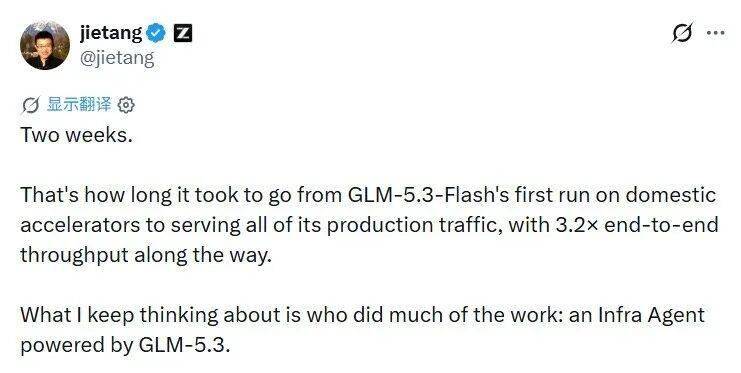
据Z.ai介绍,从GLM-5.3-Flash首次在国产加速器上运行,到承担全部生产流量,整个过程只用了不到两周。在这个过程中,端到端吞吐提升了3.2倍。
唐杰也在X上透露了这一细节:这套基础设施的大量工作由一个由GLM-5.3驱动的 Infra Agent完成,它参与了算子开发、性能瓶颈诊断以及部署服务栈优化。
01
GLM-5.3-Flash跑上10万+国产加速器
据Z.ai介绍,智谱为GLM-5.3-Flash搭建了一套生产级推理服务,运行在超过10万张国产AI加速器组成的集群上。
GLM-5.3-Flash的全部生产推理流量,都由这套系统承载。
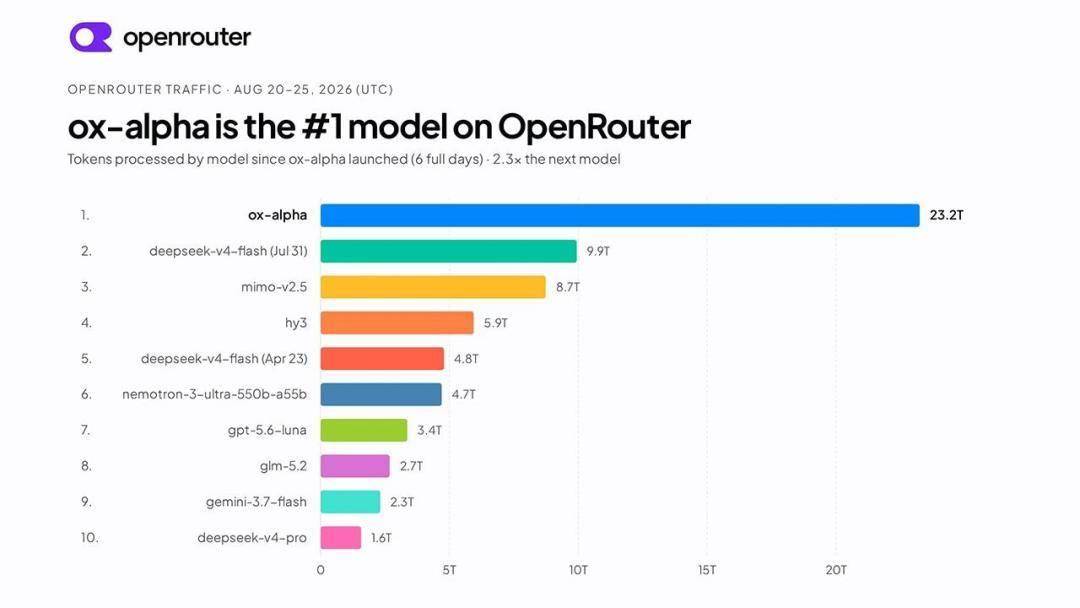
此前还以匿名模型“Ox-Alpha”在OpenCode和OpenRouter上进行测试,上线后一周内,它迅速登上两个平台的使用量榜首。
仅OpenRouter一项,8月20日至25日就处理了23.2万亿Token;结合OpenCode的数据,Z.ai披露这6天累计处理Token超过62万亿。
在推理系统适配过程中,智谱针对国产硬件重新设计了一系列优化方案,包括用计算换带宽、用通信换设备内存。
同时,系统还采用了Tensor Parallelism、ReplaySSM、W8A8量化、混合精度缓存和EPD解耦架构等技术。
经过这一系列优化,端到端服务性能提升约3倍,硬件利用率和单Token成本也达到接近主流英伟达GPU的水平。
02
一个由GLM-5.3驱动的Infra Agent
如果只是把这些工作全部归结为工程师优化了一套推理系统,这篇文章并不会和“递归自我改进”产生太大关系。
关键变化在于,智谱把大量工作交给了一个由GLM-5.3驱动的Infra Agent。
它不只是负责写代码。
在实际过程中,Agent需要阅读现有代码和Kernel,分析运行结果,提出优化假设,再修改代码、运行实验,并根据反馈继续迭代。
这和普通的Coding Agent有一个明显区别:最终评价标准不再只是代码能不能跑,而是修改之后整个推理系统到底有没有变快、有没有出错。
而这恰恰也是Agent做基础设施优化时最难的一环。
唐杰在转发中提到,当Agent卡住时,很多时候并不是因为不会写代码,而是不知道为什么性能变差了。
比如一次实验告诉它吞吐量下降20%,这个结果只能证明哪里出了问题,却无法告诉它究竟是哪一层、哪个假设或者哪一个操作导致了问题。
对于需要长时间运行的端到端Benchmark来说,如果每次实验都要等几个小时,Agent的试错速度也会非常慢。
智谱给出的解决方案,是把工程师平时依赖经验完成的“隐性反馈”拆出来,变成Agent能够直接读取的“Dense Feedback”。
03 从问题定位到Kernel优化
智谱把反馈分成了三层。
第一层是正确性反馈,回答的是计算结果对不对;
第二层是系统行为反馈,回答的是时间到底花在哪里;
第三层是性能反馈,回答的是哪一种方案更快,以及在什么条件下更快。
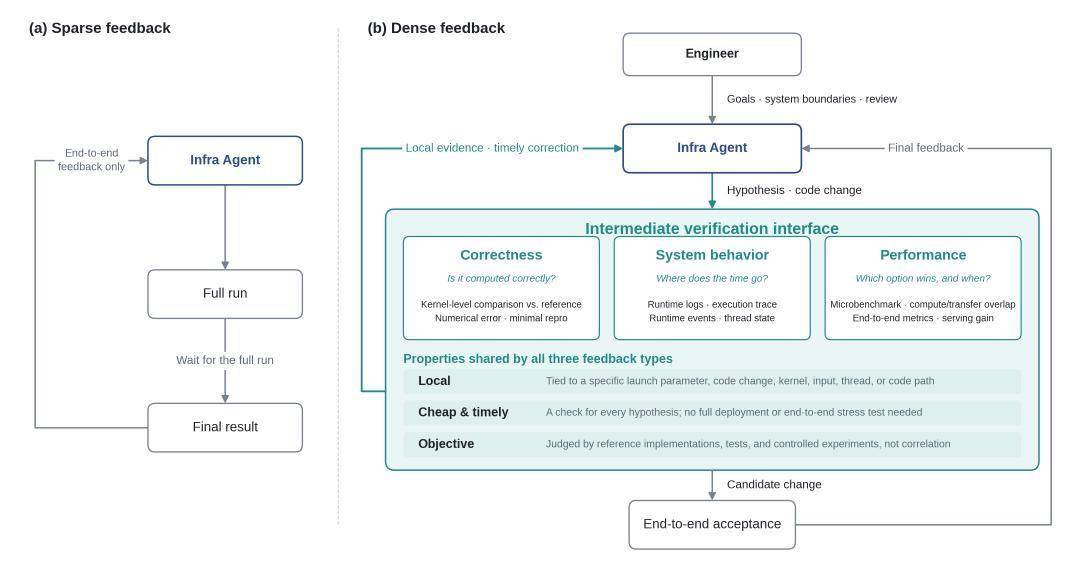
测试结果、运行日志、执行Trace、Runtime事件、Microbenchmark和端到端指标,都被接入了Agent的工作流。
这样一来,Agent拿到的就不再只是一个最终分数,而是一层层可以定位问题的反馈。
智谱公开了三个具体案例。
(1)KDA Context Parallelism
在Context Parallelism和非Context Parallelism两种模式下,相同计算出现了结果差异。
Agent进一步追踪状态传播和合并过程后发现,底层tl.dot即使输入是FP32,也默认使用TF32计算,在超长上下文的连续状态合并过程中积累了误差。
最终,工程师和Agent将两个相关操作显式设置为input_precision="tf32x3",解决了这个问题,相关修复后来合并进Flash Linear Attention的PR #1180。
(2)KV Transfer
在部分场景下,Prefill+KV Transfer相比单独Prefill存在超过20%的性能差距,而目标是将差距控制在5%以内。
Agent通过时间线分析发现,Python侧的KV Transfer并没有和DeepEP的Dispatch、Combine真正重叠执行。
继续向下追踪后,问题落到了Python GIL:
DeepEP 1.2.1中的部分节点内Dispatch/Combine操作没有显式释放Python GIL,CPU在等待GPU Token信息的同时,Mooncake Transfer的Python线程也被阻塞。
修改C++执行区间,释放GIL后,Prefill+KV Transfer与Prefill-only之间的性能差距从20%以上降到了1%以内。
(3)Kernel优化
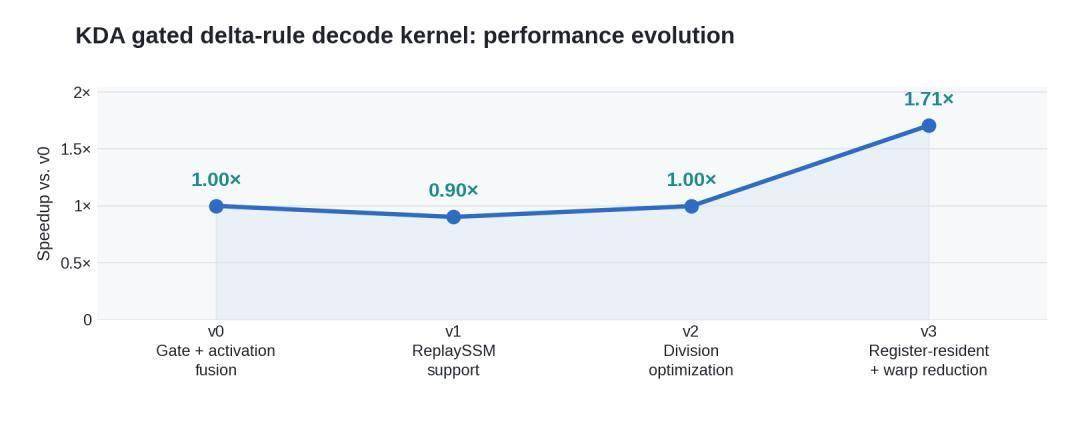
在KDA Decode Kernel的优化过程中,Agent参考了SGLang、Flash Linear Attention和DeepGEMM中的已有Kernel,并从这些代码中提炼出可以复用的优化方式。
其中一次优化最初甚至让性能变差。
Agent继续分析后发现,原来的V维度切分会导致FP32归一化和Gate计算被重复执行4次。
于是它重新调整Tile划分,把多个Tile合并到一个Thread Block中,让中间结果保存在寄存器里,同时通过Warp级Reduction消除重复计算。
虽然这种方案牺牲了一部分并行度,却减少了大量重复计算,最终,这个KDA Decode Kernel相较上一版本获得了1.71倍加速。
04
RSI的最小循环已经出现
唐杰在转发中提到,基于真实基础设施任务构建的分层、可验证反馈环境,本身也可能成为训练下一代模型所需要的环境。
代理完成的每个任务,都可以成为下一代模型的训练场。
这也是他所看到的递归自我改进方向:模型优化系统,系统服务模型。
目前,这个循环还远不能称为完整的递归自我改进。目标设定、反馈环境的构建,以及高风险变更的审查,仍然由人类负责。
但在这次GLM-5.3-Flash的实践中,一个最小的循环已经出现:模型参与优化推理基础设施,优化后的系统继续服务模型。
从首次跑上国产加速器,到不到两周后承担全部生产流量,再到端到端吞吐提升3.2倍,这个循环已经被放进真实的工程环境中验证。













